Un robots.txt bien planteado no “posiciona” por sí solo, pero sí puede evitar rastreo inútil, proteger el renderizado de errores graves y dejar claro a cada crawler qué zonas puede visitar. Esta guía incluye un generador, un tester de URLs y ejemplos listos para adaptar sin caer en plantillas agresivas.
Por Roger LlorensPublicado: 7 ago. 2026Actualizado: 9 ago. 202618–22 minNivel: básico → avanzado
Revisado contra Google Search Central, RFC 9309, WordPress y documentación oficial de crawlers.
/robots.txtDebe estar en la raíz del host. No funciona si lo colocas en una subcarpeta.
Rastreo ≠ indexaciónBloquear el crawl no garantiza que una URL desaparezca de los resultados.
500 KiBGoogle ignora el contenido situado después de su límite de tamaño para robots.txt.
≈ 24 hGoogle suele cachear robots.txt hasta 24 horas, aunque puede hacerlo más tiempo.
Respuesta rápida
robots.txt es un archivo de texto público que indica a crawlers compatibles qué rutas pueden o no rastrear. Se publica en la raíz del host, por ejemplo https://ejemplo.com/robots.txt. Sirve para gestionar acceso y gasto de rastreo, pero no es un mecanismo fiable de desindexación ni de seguridad: para excluir una página de resultados necesitas señales como noindex o acceso privado.
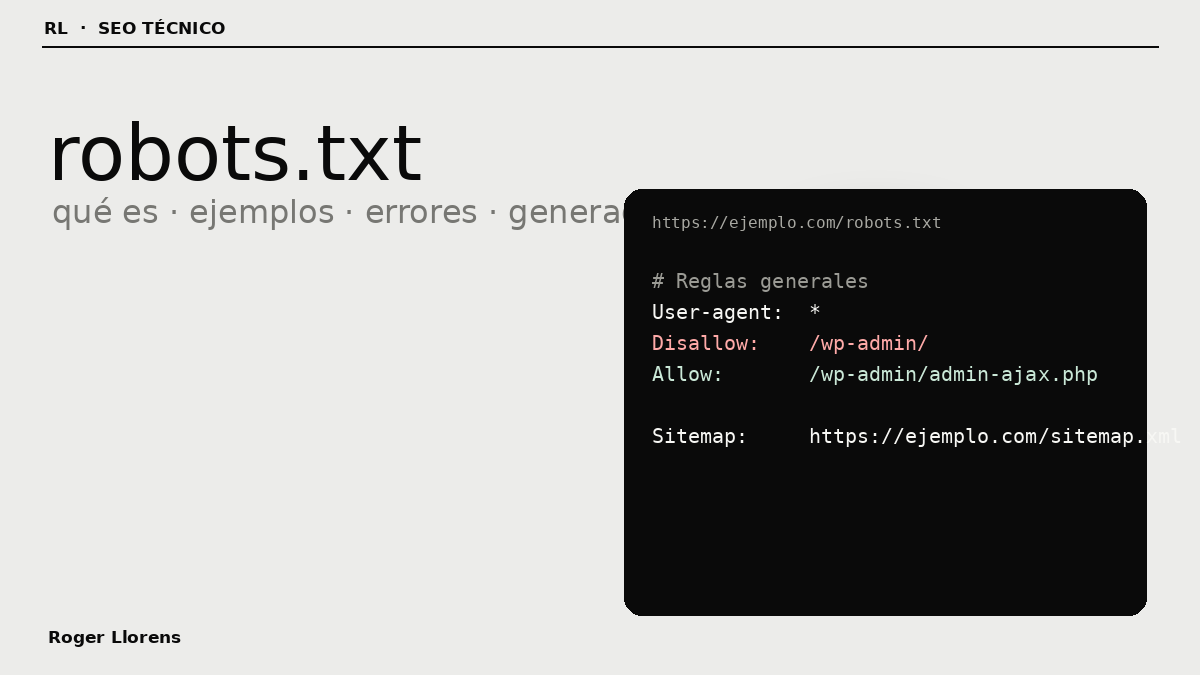
Portada visual de la guía: robots.txt controla rastreo; no sustituye noindex ni controles de acceso.
Generador de robots.txt
Conservador por defecto
El generador evita reglas que suelen romper el renderizado o bloquear más de lo necesario. Genera una base editable y muestra avisos en tiempo real. No publiques ninguna plantilla sin revisar cómo funciona tu web.
Importante: robots.txt es público y no es un mecanismo de seguridad. Para contenido privado usa autenticación o controles de acceso reales.
robots.txt generado
Diagnóstico rápidoSin alertas graves
Qué es un archivo robots.txt y qué controla realmente
robots.txt es un archivo de texto público que comunica reglas de rastreo a bots compatibles con el Robots Exclusion Protocol (REP). Antes de pedir una URL de tu sitio, un crawler compatible puede consultar ese archivo para saber qué rutas tiene permitidas y cuáles no.
Su función principal es gestionar el acceso de los rastreadores y el consumo de recursos, no decidir qué se indexa. Esa diferencia es la base de casi todos los errores SEO con robots.txt: una URL bloqueada puede seguir siendo conocida por el buscador a través de enlaces externos, sitemaps o señales previas y llegar a mostrarse sin snippet.
El estándar REP quedó formalizado en RFC 9309. Para Google, el archivo debe estar en la raíz del host, por ejemplo https://ejemplo.com/robots.txt, y sus reglas solo son válidas para ese mismo protocolo, host y puerto. Si además quieres mejorar el descubrimiento de URLs, revisa también la guía de sitemap XML.
La regla mental que evita más problemas
Si tu objetivo es “no quiero que esta URL aparezca en Google”, piensa primero en noindex o acceso privado. Si tu objetivo es “no quiero que el bot gaste recursos rastreando esta URL”, entonces robots.txt sí puede ser la herramienta adecuada.
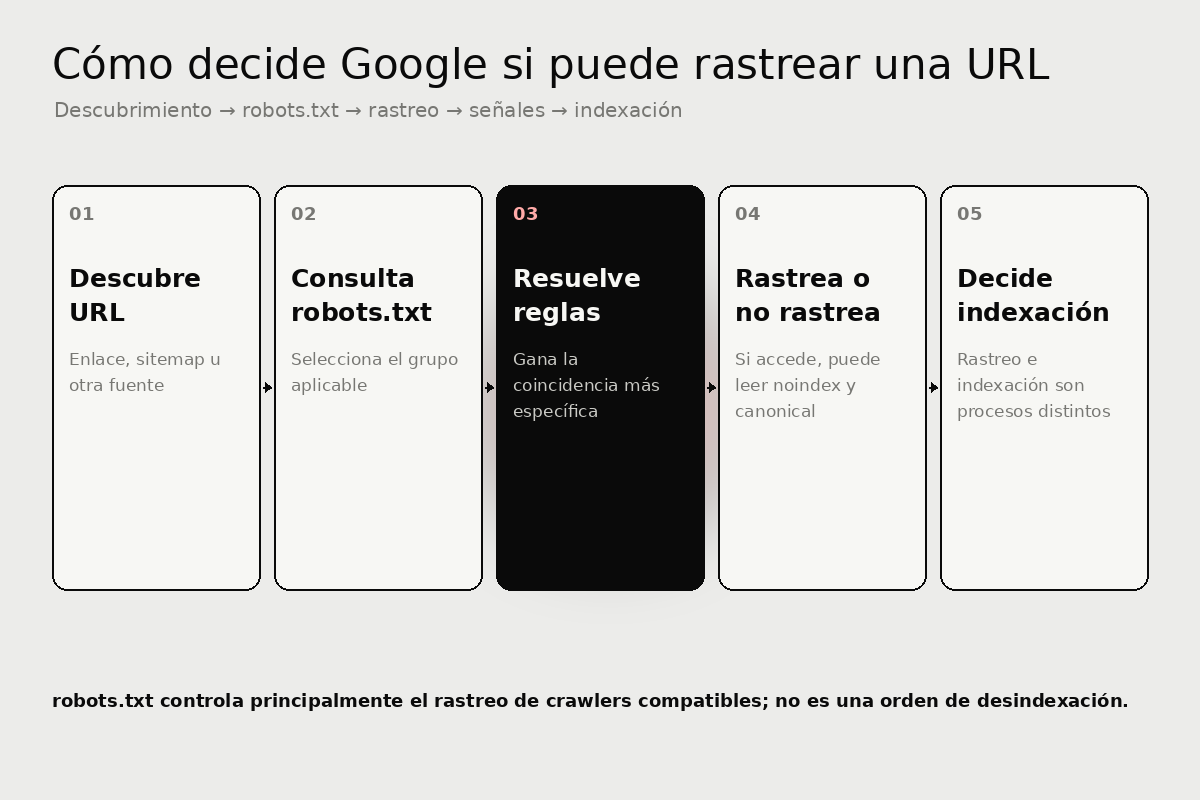
01El crawler descubre una URL por enlaces, sitemap u otras fuentes.
02Consulta robots.txt para saber si puede solicitar esa ruta.
03Si puede rastrear, obtiene HTML/recursos y procesa señales como noindex o canonical.
04Después decide si indexa, consolida o descarta la URL. Rastreo e indexación son etapas distintas.
Flujo simplificado: descubrir una URL no significa que pueda rastrearse, y poder rastrearla tampoco garantiza que termine indexada.
Las directivas que necesitas entender de verdad
Google documenta cuatro campos clave para su parser de robots.txt: User-agent, Allow, Disallow y Sitemap. Otros campos pueden ser compatibles con otros crawlers, pero no debes asumir compatibilidad universal.
Los nombres de campo no distinguen mayúsculas de minúsculas, pero los valores de ruta sí son sensibles a mayúsculas/minúsculas. Además, las reglas no se resuelven por “la última que aparezca”, sino por la coincidencia más específica.
User-agent:
Define a qué crawler se aplica el grupo
* significa cualquier crawler que no tenga un grupo más específico. Un grupo específico puede hacer que el bot ignore el grupo global, por lo que conviene repetir conscientemente las reglas que deba conservar.
Disallow:
Impide rastrear una ruta coincidente
Disallow: /admin/ bloquea URLs que empiezan por esa ruta. Un Disallow: vacío no bloquea nada.
Allow:
Crea una excepción más específica
Es útil para permitir un archivo o subruta dentro de un directorio bloqueado, por ejemplo Allow: /wp-admin/admin-ajax.php.
Sitemap:
Declara un sitemap con URL absoluta
Debe incluir protocolo y host completos. Puede haber varias líneas Sitemap: y no pertenecen a un user-agent concreto.
*
Comodín de cero o más caracteres
Google y Bing admiten una forma limitada de wildcard en las rutas. Ejemplo: /*?*color= puede usarse para patrones de filtros.
$
Ancla el final de la URL
/*.pdf$ coincide con URLs que terminan exactamente en .pdf, no con .pdf?download=1.
# comentario
Documenta sin alterar las reglas
El parser ignora el texto después de #. Es útil para dejar el motivo de una regla o la fecha de una revisión.
Crawl-delay:
No es una directiva universal
Google no la admite en robots.txt. Bing sí documenta que puede respetarla, así que una misma línea puede tener efectos distintos según el crawler.
Precedencia: gana la regla más específica
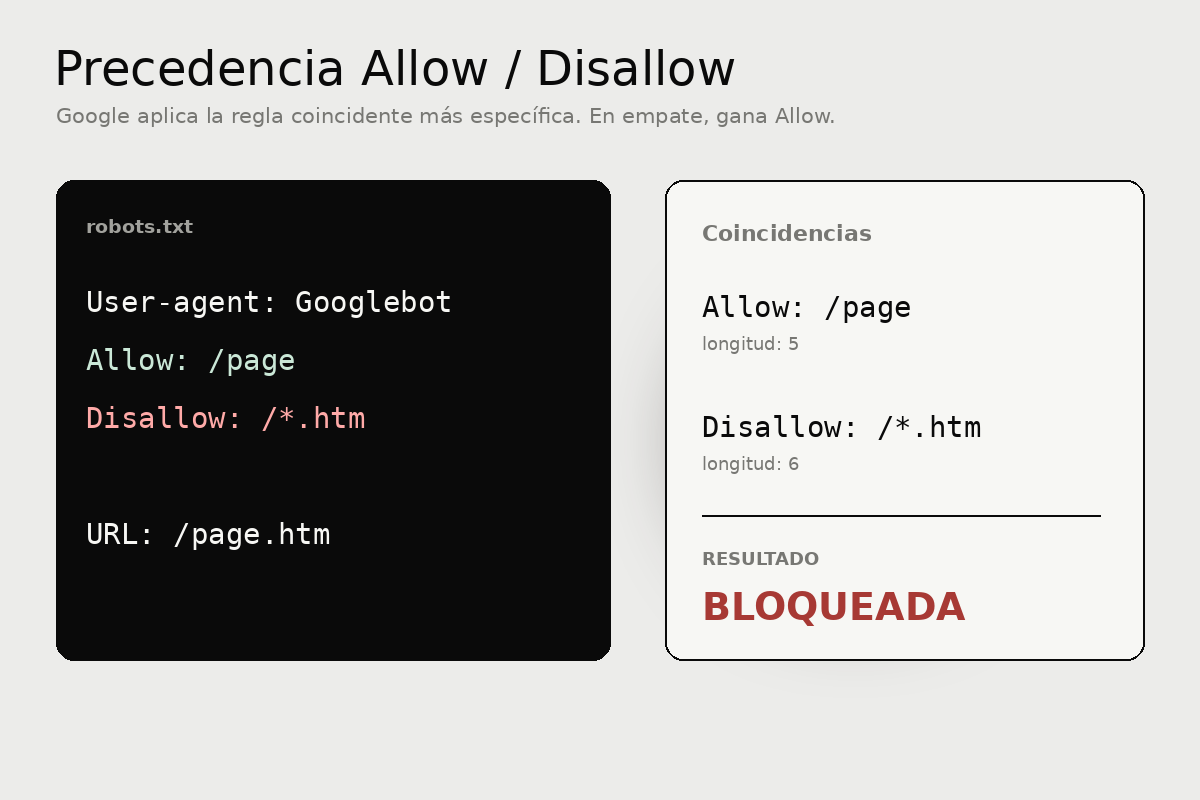
Para una URL concreta, Google compara las reglas que coinciden y aplica la más específica según la longitud de la ruta. Los comodines forman parte de esa comparación: por ejemplo, para /page.htm, Disallow: /*.htm es más específico que Allow: /page. Si Allow y Disallow empatan, Google usa la opción menos restrictiva: Allow.
Excepción normativa: /robots.txt siempre debe poder consultarse
RFC 9309 establece que la URI /robots.txt está implícitamente permitida. Por eso, incluso con User-agent: * + Disallow: /, este tester devuelve /robots.txt como permitida.
Ejemplo documentado por Google: la longitud del patrón hace que /*.htm gane frente a /page.
Tester de reglas: crawler o token de control
REP + reglas públicas principales de Google
El tester implementa selección y fusión de grupos específicos, separación frente al grupo *, Allow/Disallow, comodines *, ancla $, permiso implícito de /robots.txt, normalización UTF-8/percent-encoding, precedencia por especificidad y el límite funcional de 500 KiB de Google. Las URLs se normalizan antes de comparar; los patrones conservan percent-encoding ASCII para no asumir equivalencias que el matcher de Google distingue.
Alcance: no intenta copiar todas las tolerancias históricas de Googlebot ante archivos malformados, como directivas sin : o líneas excepcionalmente gigantes. La herramienta prioriza REP y el comportamiento público/documentado que afecta a configuraciones válidas.
Ejecutando tests internos…
Selecciona el crawler o token cuya política quieres comprobar.
Resultado estimado
Permitida
Grupo*
ReglaAllow: /wp-admin/admin-ajax.php
CoincidenciaMás específica
El tester reproduce la lógica pública principal de REP/Google para grupos, fusión de reglas, comodines, UTF-8/percent-encoding, permiso implícito de /robots.txt, límite de 500 KiB y especificidad. Google-Extended se trata como token de control de robots.txt: no tiene un user-agent HTTP independiente. Para una decisión crítica, valida también el archivo publicado y las herramientas del buscador correspondiente.
Ejemplos de robots.txt bien planteados
Permitir todo + sitemap
mínimo
No necesitas un Allow: / explícito para permitir el sitio, pero puede resultar legible en una plantilla sencilla.
Patrón inspirado en la documentación de Google para espacios de URLs con filtros. Ajusta nombres reales de parámetros y no bloquees facetas que sí quieras posicionar.
robots.txt vs noindex vs canonical: usa la señal correcta
En móvil, desliza la tabla horizontalmente para ver todas las columnas.
Comparativa de robots.txt, noindex, canonical y acceso privado según el objetivo SEO o de seguridad
Objetivo
robots.txt
noindex
canonical
Login / contraseña
Ahorrar rastreo de URLs inútiles
Sí
El bot debe rastrear para verlo
No evita el rastreo inicial
Puede impedirlo, pero no es su objetivo SEO
Evitar que una página aparezca en resultados
No es fiable
Sí, si el bot puede rastrear
Consolida, no “prohíbe” indexación
Sí para contenido realmente privado
Consolidar duplicados
No
No
Sí
No
Proteger datos sensibles
Nunca
No
No
Sí
Gestionar filtros/facetas infinitas
Sí, si no deben rastrearse
Puede desperdiciar crawl
Ayuda a consolidar, pero se rastrean
No
Error clásico: robots.txt + noindex en la misma URL
Si bloqueas la URL en robots.txt, Google puede no rastrearla y, por tanto, no ver la etiqueta noindex. Para retirar una URL del índice mediante noindex, primero debe ser rastreable. Si el problema real es decidir entre canonical, noindex, redirección o diferenciación entre URLs parecidas, consulta también la guía de canibalización SEO en Search Console.
17 errores comunes que pueden romper el rastreo
01
Publicar Disallow: / en producción
Es uno de los fallos más graves: bloquea el rastreo del sitio para el grupo afectado.
02
Usar robots.txt para “desindexar”
Una URL bloqueada puede seguir apareciendo sin snippet si el buscador la descubre por otras vías.
03
Bloquear una página que contiene noindex
El bot necesita acceder a la página para leer la directiva noindex.
04
Bloquear CSS, JS o recursos necesarios
Puede impedir que Google renderice la página como un usuario y entienda correctamente el contenido.
05
Colocar el archivo en una subcarpeta
/blog/robots.txt no controla el host. El archivo válido debe estar en la raíz del sitio.
06
Olvidar subdominios, protocolo o puertos
El robots de www no gobierna automáticamente shop, HTTP, HTTPS o un puerto distinto.
07
Usar un Sitemap relativo
La línea Sitemap debe ser una URL absoluta completa, con protocolo y host.
08
Confiar en Crawl-delay para Google
Google no lo soporta en robots.txt, aunque otros motores como Bing sí pueden interpretarlo.
09
Poner Noindex: dentro de robots.txt
No forma parte de los campos que Google soporta en su parser de robots.txt.
10
Creer que la última regla siempre gana
La especificidad de la ruta es lo importante; en empate Allow puede prevalecer.
11
Ignorar mayúsculas y minúsculas en rutas
/Privado/ y /privado/ pueden ser coincidencias distintas.
12
Usar wildcards demasiado amplios
Un patrón como /*?* puede bloquear cualquier URL con parámetros y llevarse por delante páginas útiles.
13
Bloquear facetas que sí deberían posicionar
No todos los filtros son basura SEO. Algunas combinaciones pueden ser landings útiles con demanda real.
14
Usarlo como barrera de seguridad
robots.txt es público. Nunca publiques rutas sensibles confiando en que un bot “obediente” las ignore.
15
Servir HTML o errores en vez de texto válido
Revisa Content-Type, respuesta HTTP y que la URL entregue realmente las reglas previstas.
16
Dejar crecer el archivo sin control
Google aplica un límite de 500 KiB; lo que quede después se ignora.
17
Cambiar reglas constantemente para “mover crawl budget”
Google recomienda usar robots para contenido que realmente no quieres rastrear, no como palanca temporal de reparto.
robots.txt en WordPress: menos reglas, mejor
WordPress puede generar una versión virtual de robots.txt. Su salida por defecto actual incluye el bloqueo de /wp-admin/ y permite explícitamente /wp-admin/admin-ajax.php.
Eso es una buena pista: no necesitas bloquear por defecto /wp-content/plugins/, /wp-content/themes/, CSS o JavaScript. Esos recursos pueden ser necesarios para renderizar correctamente las páginas. Para una revisión más amplia del sitio, puedes cruzarlo con este checklist SEO para WordPress.
¿Dónde editar robots.txt en WordPress?
01
robots.txt virtual de WordPressSi no existe un archivo físico que lo sustituya, WordPress puede servir la respuesta dinámicamente desde la raíz.
02
Plugin SEOYoast, Rank Math u otras herramientas pueden ofrecer una interfaz o filtros para modificar la salida. Comprueba qué termina publicándose realmente.
03
Archivo físico en la raízSi gestionas el servidor, puedes usar un archivo real en /robots.txt. Evita mantener dos fuentes de verdad distintas.
04
Comprueba siempre /robots.txt públicamenteÁbrelo en incógnito y prueba URLs críticas después de cualquier cambio de plugin, servidor, CDN o migración.
# Base WordPress conservadora
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
# Opcional si no quieres rastrear búsquedas internas
Disallow: /?s=
Disallow: /search/
# Adapta esta URL a tu plugin / sitemap real
Sitemap: https://ejemplo.com/sitemap_index.xml
No bloquees /wp-content/ o /wp-includes/ de forma indiscriminada: pueden contener recursos que Google necesita para renderizar. Si un plugin SEO modifica robots.txt, valida siempre la respuesta final que ve el crawler.
robots.txt y crawl budget: cuándo importa de verdad
En un sitio pequeño o medio que Google descubre y rastrea con normalidad, no deberías obsesionarte con el crawl budget. La documentación actual de Google reserva la optimización avanzada de presupuesto de rastreo sobre todo para sitios muy grandes, muy cambiantes o con muchas URLs descubiertas pero no indexadas.
Donde robots.txt sí puede aportar mucho valor es en espacios de URLs casi infinitos: navegación por facetas, combinaciones de filtros, calendarios sin límite, parámetros de ordenación o resultados internos. En esos casos, el bot puede consumir recursos recorriendo miles o millones de variaciones que no quieres posicionar.
La clave es separar dos escenarios: si una URL no debe rastrearse nunca, robots.txt puede ser eficiente; si necesitas que Google vea un canonical o un noindex, debes permitir el rastreo al menos hasta que esa señal sea procesada.
Umbrales orientativos de Google en su guía avanzada
Google cita como casos típicos sitios con más de 1 millón de páginas que cambian semanalmente, sitios de 10.000+ páginas que cambian a diario o propiedades con una gran proporción de URLs “Descubiertas: actualmente sin indexar”. No son límites exactos.
Qué pasa si robots.txt devuelve 200, 404, 3xx o 5xx
2xx
Google procesa el archivo
La respuesta de éxito hace que Google use las reglas entregadas por el servidor.
3xx
Sigue redirecciones, con límite
Google sigue al menos cinco saltos. Si no obtiene el archivo, puede tratarlo como si fuera un 404.
4xx
Normalmente: sin restricciones
Excepto 429, Google trata los errores 4xx como si no existiera un robots.txt válido, es decir, no aplica restricciones de rastreo.
5xx
Puede frenar el rastreo
Google puede parar el crawl inicialmente, reutilizar una versión válida anterior y seguir reintentando durante un periodo prolongado.
0–12 hGoogle detiene el rastreo del sitio
Sigue intentando recuperar robots.txt. Es la ventana de mayor impacto inmediato.
12 h–30 díasPuede reutilizar la última versión válida
Si existe una copia buena cacheada, Google puede usarla mientras reintenta. Sin copia cacheada, asume que no hay restricciones de rastreo.
>30 díasDepende de la disponibilidad general
Si el sitio está accesible, puede actuar como si no hubiera robots.txt; si hay problemas generales de disponibilidad, puede detener el rastreo y seguir comprobando periódicamente.
Google indica que suele cachear robots.txt hasta 24 horas, aunque puede mantenerlo más tiempo si no consigue refrescarlo por timeouts o errores 5xx. Por eso un cambio correcto puede no reflejarse de forma instantánea en todos los crawlers.
Un fallo 5xx en robots.txt merece prioridad: durante las primeras 12 horas Google puede detener el rastreo del sitio. No trates esta URL como un archivo secundario; forma parte de la infraestructura crítica de SEO técnico.
Rastreadores de IA: search, entrenamiento y controles separados
En 2026 conviene tratar los bots de IA igual que cualquier otra política de rastreo: define qué producto quieres permitir o excluir y usa el token oficial documentado por el proveedor.
OpenAI diferencia OAI-SearchBot, relacionado con descubrir y mostrar contenido en ChatGPT Search, de GPTBot, que puede bloquearse para excluir contenido de posible entrenamiento. Bloquear OAI-SearchBot reduce la posibilidad de que el contenido se use en resúmenes y fragmentos de búsqueda, pero una URL conocida por otras fuentes todavía puede aparecer como enlace o título en determinadas situaciones. Si el objetivo es impedir esa aparición, OpenAI recomienda noindex y el crawler debe poder acceder a la página para leerlo.
Por su parte, Google ofrece Google-Extended como token de control de robots.txt: no tiene un user-agent HTTP independiente; el rastreo se realiza con user-agents existentes de Google y el token controla determinados usos del contenido en Gemini. Google especifica además que no afecta a la inclusión ni al ranking en Google Search.
Ejemplo de política editorial
Puedes querer que tu contenido sea descubrible en buscadores y asistentes, pero excluirlo del entrenamiento. Eso exige reglas por user-agent; un bloqueo genérico a * no distingue usos.
Permitir Search y bloquear GPTBot
OpenAI
Si el grupo global ya permite tu contenido, basta con no bloquear OAI-SearchBot y crear un grupo específico para GPTBot.
Cómo validar robots.txt antes y después de publicarlo
01
Abre /robots.txt en incógnito
Confirma que carga exactamente el archivo previsto y no una caché, página HTML o respuesta del CDN.
02
Comprueba HTTP 200 y UTF-8
La respuesta debe ser texto plano válido. Revisa cabeceras si tienes acceso al servidor o a DevTools.
03
Testea URLs críticas
Home, categorías, posts, productos, CSS/JS, imágenes importantes, sitemap y cualquier ruta afectada por wildcards.
04
Revisa el informe robots.txt de Search Console
Muestra archivos detectados, última lectura y advertencias/errores para propiedades compatibles. Para interpretar después el rendimiento orgánico, puedes cruzarlo con la guía de muchas impresiones y pocos clics en Search Console.
05
Usa Inspección de URL
Comprueba si una URL importante está accesible para Google y si faltan recursos de renderizado. Si esa página utiliza datos estructurados, valida también la implementación con esta guía de Schema markup y JSON-LD.
06
Mira Estadísticas de rastreo y logs
Si el objetivo era reducir facetas o filtros inútiles, verifica que el patrón de crawl cambie realmente.
07
Valida el sitemap
La URL declarada debe devolver 200 y contener solo URLs canónicas que quieras descubrir e indexar.
08
Repite la auditoría tras migraciones
Un cambio de dominio, subdominio, CDN o protocolo puede dejar reglas apuntando al host equivocado.
Preguntas frecuentes sobre robots.txt
¿robots.txt evita que una página aparezca en Google?
No de forma fiable. Puede impedir que Google rastree el contenido, pero la URL todavía puede conocerse e incluso aparecer sin snippet. Para excluir una página de resultados, usa noindex permitiendo el rastreo o protege el contenido con autenticación.
¿Dónde debe estar el archivo robots.txt?
En la raíz del host: por ejemplo, https://ejemplo.com/robots.txt. Un robots.txt dentro de /blog/ o cualquier subcarpeta no controla el sitio.
¿Tengo que poner Allow: / para permitir todo?
No. Si no hay una regla que bloquee la URL, el rastreo está permitido por defecto para ese grupo. Allow: / puede usarse por legibilidad, pero no es obligatorio.
¿Puedo usar noindex dentro de robots.txt?
No como directiva soportada por Google. Usa una meta robots noindex en HTML o X-Robots-Tag en la cabecera HTTP y permite que el crawler acceda a la URL para leerla.
¿Google respeta Crawl-delay?
No en robots.txt. Google documenta que crawl-delay no está soportado. Bing sí puede respetarlo, por lo que debes revisar las reglas del motor que quieras controlar.
¿Debo bloquear wp-content, plugins y themes?
No de forma general. Allí suelen vivir CSS, JS, fuentes e imágenes necesarias para renderizar la web. Bloquear recursos importantes puede hacer que Google vea una página distinta a la del usuario.
¿robots.txt distingue mayúsculas y minúsculas?
Los nombres de campo son case-insensitive, pero los valores de ruta se comparan de forma sensible a mayúsculas/minúsculas. /Carpeta/ y /carpeta/ pueden no ser equivalentes.
¿Qué significa User-agent: *?
Es el grupo genérico para crawlers que no encuentran un grupo más específico que coincida con su token de user-agent.
¿Puedo incluir varios sitemaps?
Sí. Google indica que puedes declarar varias líneas Sitemap y que deben usar URLs absolutas completas.
¿Cuánto tarda Google en detectar un cambio?
Google suele cachear robots.txt hasta 24 horas, aunque puede hacerlo más tiempo en determinados fallos de red o servidor. Search Console permite revisar el estado y, en emergencias, solicitar una nueva lectura.
¿Un 404 en robots.txt bloquea Googlebot?
Normalmente no. Google trata los 4xx —excepto 429— como si no existiera un robots.txt válido, por lo que asume que no hay restricciones de rastreo.
¿robots.txt sirve para ocultar una carpeta secreta?
No. El archivo es público y sus rutas pueden revelar nombres de directorios. Para información sensible necesitas autenticación y controles de acceso en servidor.